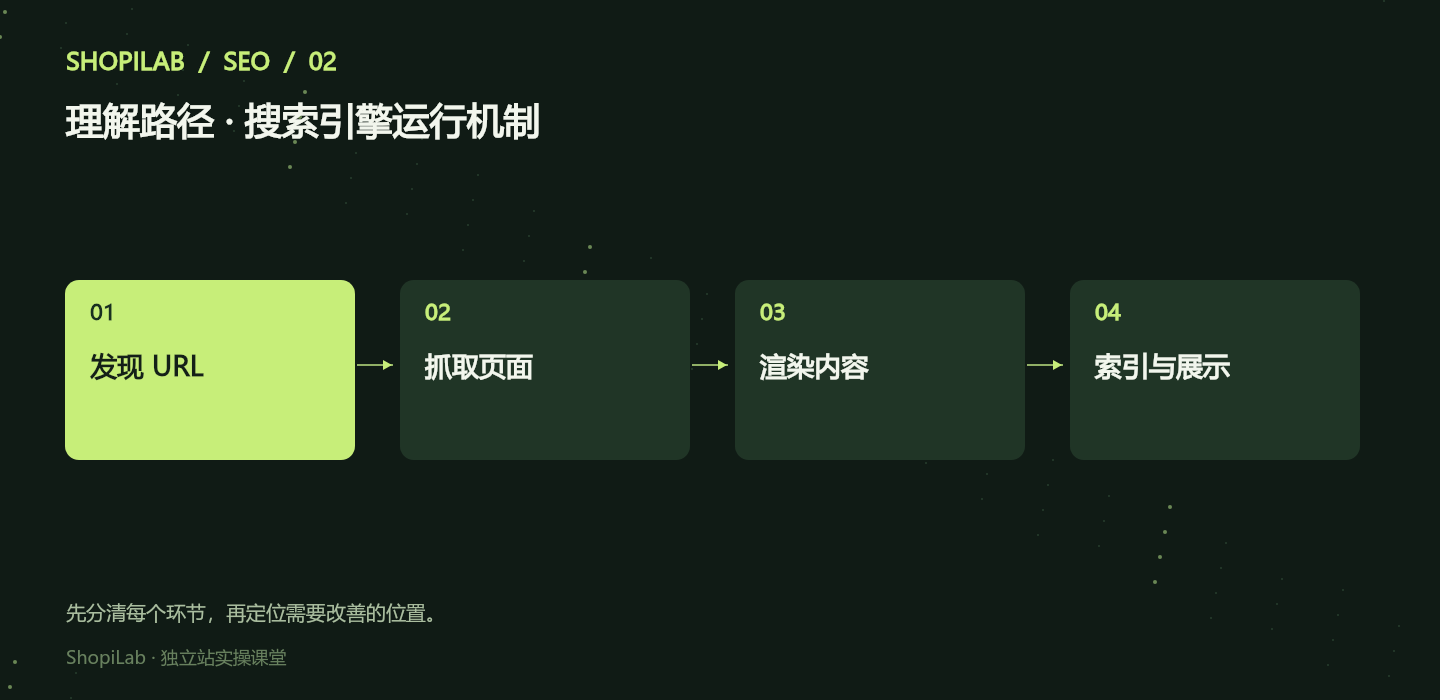
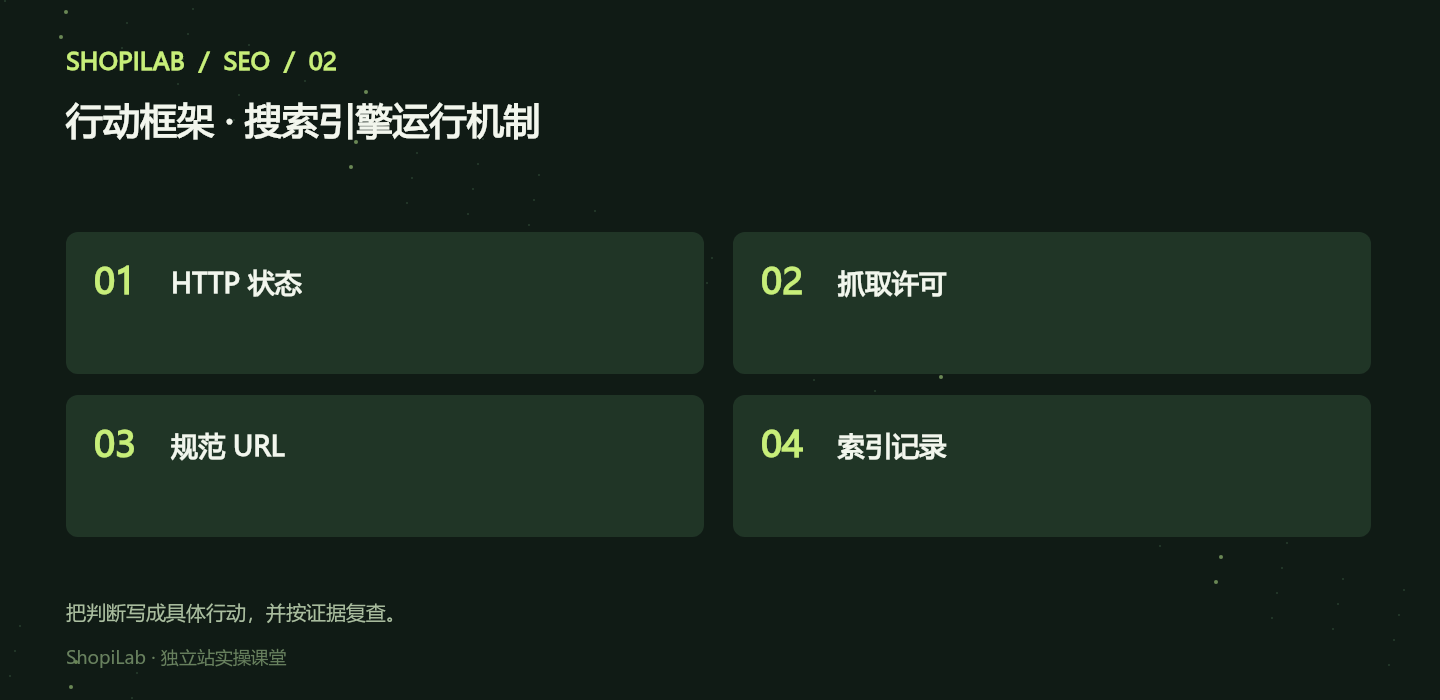
START HERE / SHOPILAB 这节课要解决什么 一个 URL 能在浏览器打开,只说明用户可以访问,并不代表搜索引擎已经收录,更不代表它会获得排名。把发现、抓取、渲染、索引和展示拆开检查,才能找到真正需要处理的环节。 本课目标 用一条具体 URL 判断搜索状态,并选择对应的排查动作。 01 / SEO FOUNDATIONS 发现:让重要页面拥有可跟随的入口 搜索引擎通过链接、站点地图等途径发现 URL。重要商品不能只藏在站内搜索框、筛选动作或需要登录的区域里。为它安排来自集合页、导航或相关文章的普通链接。 Shopify 通常会生成 sitemap.xml,提交站点地图有助于发现页面,但不承诺全部抓取或收录。上架后检查该商品是否发布到在线商店、是否有实际入口。 02 / SEO FOUNDATIONS 抓取:服务器是否返回正确响应 200 通常表示页面成功返回;301/308 表示永久跳转;404/410 表示页面不存在或已移除;5xx 表示服务器错误。返回 200 的空页面或错误提示仍可能被视作软 404。 robots.txt 用于控制抓取,并非可靠的移除索引工具。如果禁止抓取,搜索引擎可能无法读取页面上的 noindex。先明确要限制抓取还是要阻止索引,再处理规则。 图 1 · 发现 URL → 抓取页面 → 渲染内容 → 索引与展示 03 / SEO FOUNDATIONS 渲染:主要内容是否可以被理解 浏览器里看到的内容可能依赖 JavaScript。检查商品名、描述、价格和关键链接是否出现在渲染后的页面,避免正文完全依赖交互后才加载。 Search Console 的实时测试可以帮助检查当前可访问情况及渲染结果。它回答“现在能否测试”,不等于索引数据库已经更新,也不保证未来排名。 状态对应排查路径 观察结果 无法抓取 先检查 登录限制、robots、服务器响应 下一步 修复访问后做实时测试 观察结果 重复页未收录 先检查 canonical、相似内容、参数入口 下一步 统一内部链接与规范版本 观察结果 已索引但没有点击 先检查 查询需求、页面匹配、展示位置 下一步 分析效果报告与搜索结果 04 / SEO FOUNDATIONS 索引:页面是否被选作可展示版本 搜索引擎会评估重复内容、规范版本和页面价值。canonical 是规范化信号,不是强制命令;相似商品参数页可能被归到另一个版本。查看用户声明与 Google 选择的规范 URL 是否符合预期。 “已发现,尚未编入索引”和“已抓取,尚未编入索引”是不同状态。先看页面是否有独特内容、内部入口及技术异常,不要只反复请求索引。 WORKED EXAMPLE 一条集合页的检查示例 新的 /collections/travel-brewers 返回 200,实时测试通过,但索引报告仍显示未收录。先确认该集合有商品、独特介绍、导航入口和正确规范 URL;不要因为实时测试成功便宣布已经收录。修复后记录时间,之后再看索引报告是否变化。 图 2 · HTTP 状态 → 抓取许可 → 规范 URL → 索引记录 05 / SEO FOUNDATIONS 展示:收录后仍需要匹配查询 索引只是参与检索的前提。实际展示还与查询相关性、内容质量、语言地区和竞争有关。site: 搜索可作辅助观察,不能代替 URL 检查和效果报告。 对同一 URL 记录检查日期、HTTP 状态、索引结论、规范 URL 和页面任务。技术问题修复后先验证当前状态,再等待重新处理,最后观察查询曝光。 PRACTICE / APPLY IT 把方法用到自己的店铺 选择一个已发布商品和一个集合页,分别执行 URL 检查。记录当前测试与已保存索引结果的差异。按最靠前的异常选择一项修复,验证后再提交重新处理。 完成前再核对 01 重要页面有站内链接 02 响应与页面实际内容一致 03 实时测试和索引记录分开判断 04 规范版本与业务目标一致 QUESTIONS 常见问题 提交 sitemap 就能全部收录吗? 不能。站点地图提供发现线索,搜索引擎仍会独立决定抓取、规范化和索引。 用 robots.txt 能立刻删除搜索结果吗? 不能。它控制抓取;需要移除索引时,应按具体情况使用可被读取的 noindex、删除状态或官方移除工具,并保持长期处理一致。 CONTINUE LEARNING 下一课,把方法继续用下去 SEO关键词挖掘:找到客户真实的搜索需求 ← 上一课 进入下一课 →